

Nella gestione di un incidente, rilevare un attacco non è tutto: conta anche quanto velocemente lo si contiene. Per questo il MTTR (Mean Time To Respond), il tempo medio tra rilevazione e risposta, è un indicatore sempre più importante.
I motivi sono due. Il primo è la velocità degli attaccanti, che usano l'intelligenza artificiale per accorciare proprio le fasi tra il primo accesso e il controllo della rete. La finestra utile per intervenire si riduce, e la partita si decide nei minuti che seguono l'alert.
Il secondo è che la risposta dipende ancora da attività manuali, e in alcuni casi è necessaria l'attività del cliente guidata dal provider MDR. Il lavoro manuale da ridurre, quindi, non è solo quello degli analisti MDR, ma anche quello di chi lavora dentro le aziende.
È qui che entra in gioco l'HyperAutomation.
Il breakout time si accorcia
Il breakout time è il tempo tra l'accesso iniziale di un attaccante e l'inizio del suo movimento laterale nella rete della vittima. È la misura più concreta della finestra a disposizione di chi difende.
Secondo le più recenti analisi di threat intelligence, nel 2025 il breakout time medio degli attacchi di matrice criminale (eCrime) è sceso a 29 minuti. Rispetto al 2024 gli attaccanti sono stati il 65% più veloci, e il caso più rapido osservato è durato 27 secondi.
A comprimere questi tempi contribuisce l'intelligenza artificiale. Una ricerca di Anthropic ha mappato su MITRE ATT&CK 832 account bloccati per attività malevole tra marzo 2025 e marzo 2026. Parte di questi risultati è confluita nel Data Breach Investigations Report (DBIR) 2026 di Verizon.
Il quadro che emerge è netto: l'uso dell'AI si sta spostando dall'accesso iniziale alle attività svolte dentro la rete compromessa. Gli attaccanti più pericolosi la concentrano sulle fasi operative più impegnative: discovery degli account, movimento laterale ed escalation dei privilegi. Sono proprio le attività che determinano il breakout time.
Non solo: gli attori più evoluti costruiscono architetture che permettono ai modelli di concatenare più fasi dell'attacco con un intervento umano minimo. Se l'attacco procede a velocità macchina, una risposta che dipende da passaggi manuali parte in svantaggio.
Cos'è l'HyperAutomation (e perché non è la SOAR di ieri)
Con HyperAutomation si intende l'automazione end-to-end dei processi di sicurezza: dalla ricezione dell'alert all'arricchimento, fino al contenimento e alla notifica. Non si tratta di automatizzare singoli task, ma di orchestrare l'intera catena di azioni tra strumenti diversi.
L'idea non è nuova. Le piattaforme SOAR (Security Orchestration, Automation and Response) hanno dimostrato per prime il valore dell'automazione nel SOC. Si basano però su playbook statici e script personalizzati, costruiti e mantenuti da ingegneri dedicati.
Quando un'API cambia, il playbook si rompe. Quando arriva uno scenario non previsto, l'alert torna in coda a un analista. L'HyperAutomation nasce per superare questi limiti:
| Aspetto | SOAR tradizionale | HyperAutomation |
|---|---|---|
| Architettura | Monolitica, rallenta nei picchi di alert | Cloud-native ed event-driven, scala in modo elastico |
| Integrazioni | Sviluppate e mantenute a mano, fragili ai cambi di API | Centinaia di connettori nativi, mantenuti dalla piattaforma |
| Ruolo dell'AI | Assente o marginale | Agenti AI per triage, arricchimento e investigazione |
| Controllo umano | Spesso binario: tutto automatico o tutto manuale | Autonomia calibrata per tipo di azione e livello di rischio |
Un aspetto merita attenzione: nelle piattaforme più mature l'AI aiuta a ragionare sull'alert, mentre le azioni di risposta restano deterministiche. Il contenimento passa da workflow definiti e validati, che si comportano ogni volta allo stesso modo.
Per un provider MDR conta anche la scala. Chi protegge decine di ambienti diversi ha bisogno di un'architettura multi-tenant, capace di reggere i picchi di alert senza mettere in coda le azioni di contenimento.
In un servizio MDR, la response fa la differenza
Detection e analisi sono il cuore di un servizio MDR, e oggi possono contare su telemetria ricca e strumenti maturi. La differenza, però, si gioca subito dopo: quando l'alert è confermato e la minaccia va contenuta.
A quel punto entrano in gioco i passaggi manuali: accedere a più console, autenticarsi su ognuna, individuare l'host o l'utente giusto, coordinarsi con il team IT del cliente. Di notte o nel weekend, quando le persone da coinvolgere non sono davanti a uno schermo, i tempi si allungano ancora. Ogni secondo perso tra login multipli, cambi di console e coordinamento manuale è tempo regalato all'attaccante.
In molti modelli MDR, inoltre, il SOC segnala l'incidente e indica cosa fare, ma l'esecuzione resta parzialmente in carico anche al cliente. Ogni incidente si traduce così in lavoro operativo per il suo team, spesso fuori orario.
Questo non significa togliere le persone dal processo. In un servizio MDR la componente umana resta fondamentale: sono gli analisti a leggere il contesto e a investigare. Sono loro a distinguere un falso positivo da un attacco reale e a guidare la risposta agli incidenti più complessi.
L'HyperAutomation si concentra invece su attività specifiche: ripetitive, urgenti e ben definite. In questi casi la decisione si prende a monte, nel playbook, e al momento dell'incidente va solo eseguita, in fretta e senza errori. L'automazione agisce direttamente sugli strumenti già presenti nell'infrastruttura del cliente:
- Endpoint: isolamento dell'host compromesso tramite l'EDR.
- Rete: blocco degli indirizzi IP malevoli e del traffico sospetto, tramite sonde e dispositivi di rete.
- Identità: disattivazione dell'utente, revoca delle sessioni attive e reset della password, su Active Directory e sulle piattaforme cloud.
- Comunicazione: notifica al team giusto sul canale corretto e aggiornamento del ticket, con il riepilogo delle azioni svolte.
Il cliente non deve più eseguire in prima persona le attività di contenimento. Viene informato in tempo reale, mentre il SOC prosegue l'investigazione con la minaccia già circoscritta.
Un esempio pratico: lo stesso incidente, due risposte
Per capire cosa cambia davvero, mettiamo a confronto i due approcci sullo stesso scenario. Un alert segnala la compromissione di una postazione e il SOC conferma l'incidente. Per contenerlo servono tre azioni, in sequenza:
- isolare l'host compromesso, per interrompere i movimenti dell'attaccante;
- disattivare l'utente associato, perché le sue credenziali potrebbero essere già nelle mani dell'attaccante;
- allertare il team del cliente, sul canale giusto e con le informazioni necessarie.
La risposta manuale, a carico del cliente. Bloccare la macchina richiede circa 10 minuti, tra accesso alla console EDR, autenticazione e ricerca dell'host. Disattivare l'utente significa fare login su un'altra piattaforma e svolgere un'attività dedicata: altri 10 minuti circa. Poi c'è la notifica, che richiede di sapere a chi scrivere e di individuare il canale o il gruppo giusto.
Il totale supera i 20 minuti, con un margine di errore umano a ogni passaggio. E ogni passaggio richiede che una persona del cliente sia disponibile, abbia gli accessi giusti e conosca quella piattaforma.
La risposta con l'HyperAutomation. Appena l'alert soddisfa le condizioni previste dal playbook, le tre azioni partono in sequenza, senza attese. L'host viene isolato, l'utente disattivato e il messaggio arriva al team già instradato sul canale corretto, con il riepilogo di quanto fatto. Il tempo complessivo si avvicina allo zero, e al cliente non è richiesta alcuna azione: riceve solo la notifica.
| Azione | Intervento manuale | Con HyperAutomation |
|---|---|---|
| Isolamento dell'host | Accesso alla console EDR, autenticazione, ricerca dell'host | Eseguito dal playbook tramite API |
| Disattivazione dell'utente | Login su un'altra piattaforma e attività dedicata | Eseguita dal playbook, con revoca delle sessioni |
| Notifica al team | Capire a chi scrivere, trovare il canale o il gruppo giusto | Messaggio instradato automaticamente sul canale corretto |
| Attività a carico del cliente | Tre interventi su piattaforme diverse, a qualsiasi ora e con margine di errore umano | Nessuna: l'automazione esegue, il cliente riceve solo la notifica |
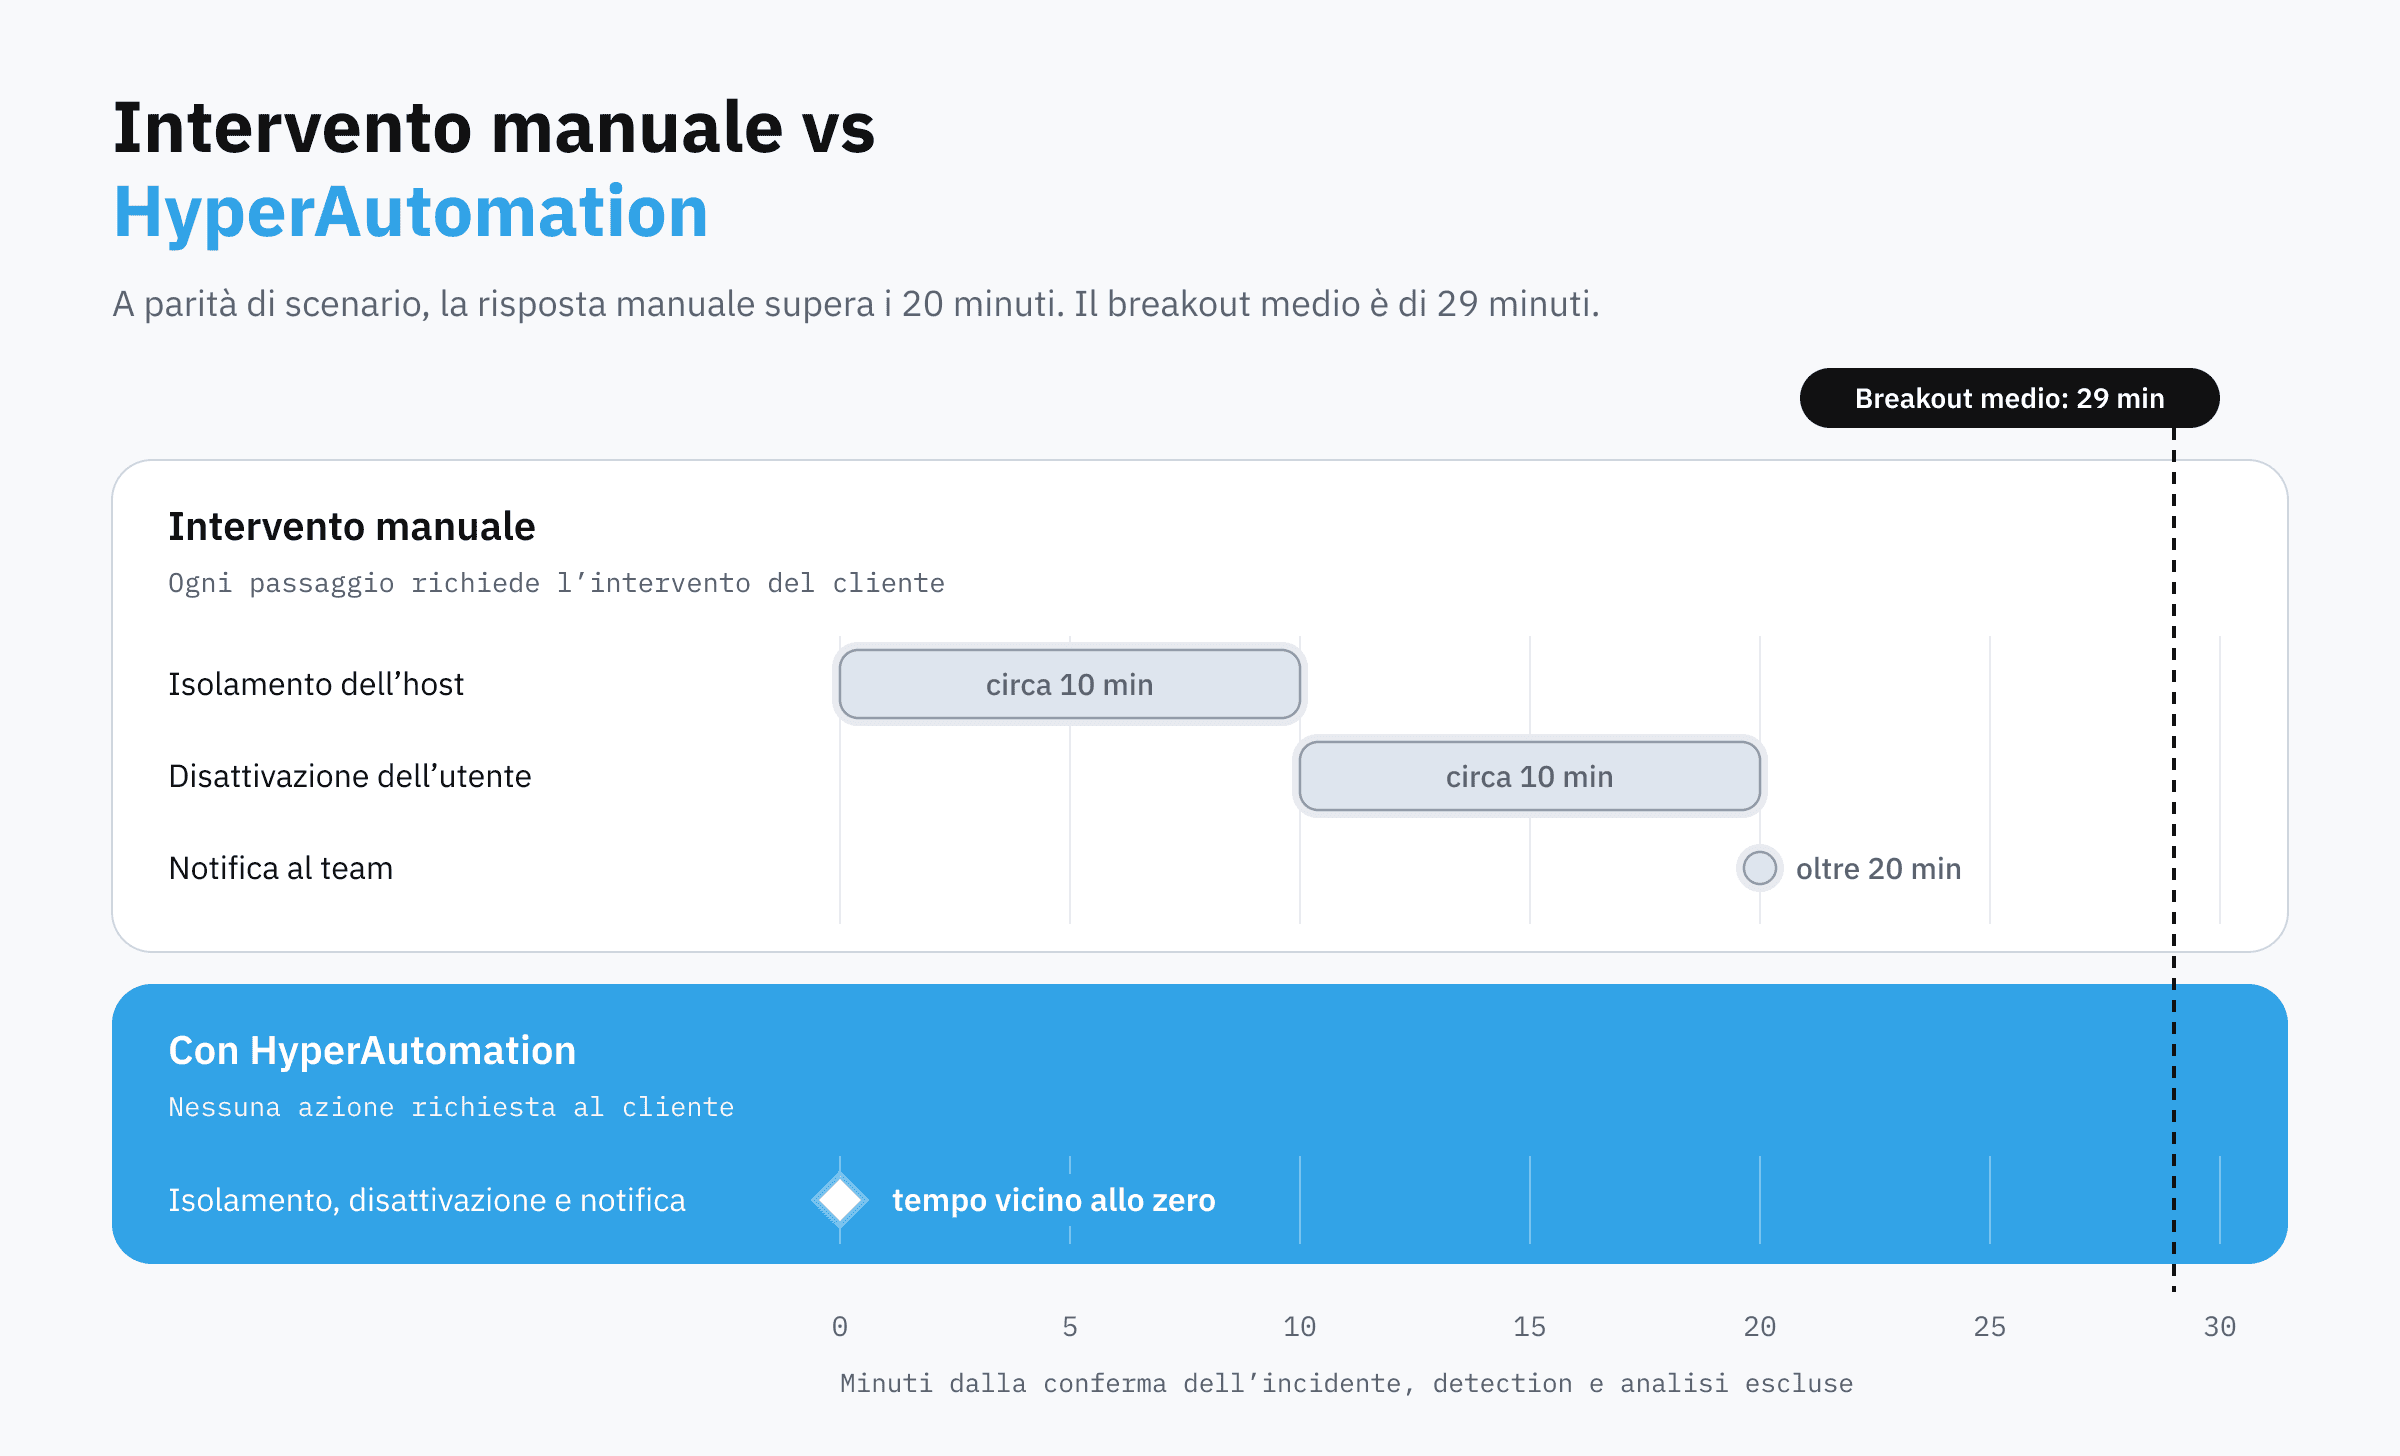
Il punto non è solo la somma dei minuti risparmiati. Con un breakout time medio di 29 minuti, oltre 20 minuti di risposta manuale lasciano un margine minimo. E il conto parte solo dopo detection e analisi.
Nei casi più rapidi, l'attaccante si sarebbe già mosso lateralmente prima ancora del primo login in console. Ogni minuto guadagnato con l'automazione è un minuto sottratto all'attaccante, e ogni passaggio automatizzato è un'attività in meno per il cliente.
Automatizzare sì, ma con controllo
Affidare a un sistema automatico l'isolamento di un host o la disattivazione di un utente è una decisione che richiede fiducia. E la fiducia si costruisce con la trasparenza, non con la sola velocità. Per questo un'HyperAutomation ben progettata si regge su alcuni principi:
- Playbook su misura: le azioni automatiche vengono definite e validate insieme al cliente, sulla base della sua infrastruttura. Nessuna automazione generica.
- Perimetro chiaro: per ogni azione si stabilisce se può partire in autonomia o se richiede la validazione di un analista. I sistemi più critici, come i domain controller, possono essere esclusi dal contenimento automatico.
- Audit log consultabile: ogni azione viene registrata, così il cliente può verificare in qualsiasi momento cosa è stato fatto, quando e su quale sistema.
- Notifiche dove si lavora già: gli aggiornamenti arrivano in tempo reale sulle piattaforme di collaborazione in uso, come Microsoft Teams o Slack, senza dover consultare uno strumento in più.
- Azioni reversibili: un host isolato si ricollega e un account disattivato si riabilita con la stessa rapidità, una volta chiarito l'incidente.
L'automazione riduce il tempo di risposta, non la visibilità su ciò che accade.
Un'HyperAutomation su misura, costruita con il provider MDR
L'HyperAutomation non è un prodotto da accendere: funziona solo se è costruita sull'infrastruttura, sugli strumenti e sui processi di chi la adotta. Due organizzazioni con lo stesso EDR possono avere asset critici, catene di escalation e canali di comunicazione completamente diversi.
Per questo applicarla richiede un confronto diretto con il provider MDR, che la progetta e la mantiene sulle esigenze specifiche del cliente. Il percorso passa, in genere, da quattro fasi:
- Assessment: si mappano l'infrastruttura, gli strumenti di sicurezza in uso, gli asset critici e i processi esistenti, comprese le persone da coinvolgere in caso di incidente.
- Progettazione dei playbook: si stabilisce quali scenari attivano quali azioni e cosa può partire in autonomia. Si definiscono anche le eccezioni, come i sistemi da non toccare, e chi avvisare su quale canale.
- Integrazione e validazione: il provider collega gli strumenti del cliente e verifica i playbook prima di renderli operativi.
- Evoluzione continua: quando cambiano l'infrastruttura o le minacce, i playbook vengono aggiornati ed estesi a nuovi strumenti.
Un'automazione generica rischia di essere inutile, perché non copre gli strumenti reali, o dannosa, perché agisce su sistemi che non andrebbero toccati. È la personalizzazione a rendere l'HyperAutomation allo stesso tempo veloce e sicura.
Cosa cambia per il cliente (e per il SOC)
Il beneficio più immediato è per il cliente, che durante un incidente ha molte meno cose da fare. Con l'HyperAutomation non deve più:
- ricevere la segnalazione del SOC, magari di notte, e interpretare le istruzioni, per le attività che possono essere automatizzate;
- accedere a console diverse, ognuna con le proprie credenziali, per isolare host e disattivare utenti quando serve;
- capire chi avvisare e su quale canale, mentre l'incidente è in corso;
- confermare al SOC l'esito di ogni azione.
Il cliente resta informato in tempo reale e conserva il controllo grazie all'audit log, ma le azioni di contenimento non passano più dalle sue mani. Il suo team resta libero per le attività a maggior valore, senza dover mantenere personale reperibile e formato su ogni strumento solo per il contenimento.
Per chi lavora nel SOC, l'HyperAutomation non toglie lavoro agli analisti: lo rende più efficace. Con il contenimento già avviato, possono concentrarsi su ciò che richiede giudizio umano: investigazione, threat hunting e miglioramento continuo dei playbook.
Cambia anche la qualità dell'esecuzione. Un playbook si comporta allo stesso modo alle tre del pomeriggio e alle tre di notte, senza dimenticanze né passaggi saltati.
Il risultato è un servizio che tiene il passo di attaccanti che usano l'AI per muoversi più in fretta, senza scaricare sul cliente il peso della risposta.
L'HyperAutomation nei processi MDR di Certego
In Certego abbiamo integrato l'HyperAutomation direttamente nei processi con cui eroghiamo i nostri servizi MDR. Lo facciamo con PanOptikon® HyperAutomation, il modulo di orchestrazione e risposta automatizzata della nostra piattaforma di Security Operations. Riduce i tempi di risposta e solleva il cliente dalla gestione operativa delle attività di contenimento.
Il modulo agisce direttamente sugli strumenti già presenti nell'infrastruttura del cliente, come la sonda di rete Certego, EDR/XDR, Active Directory e Microsoft 365. Per i sistemi interni, un componente installato nella rete del cliente esegue le azioni in LAN e comunica solo tramite connessioni in uscita cifrate.
Per noi la personalizzazione è il punto di partenza. I playbook nascono in fase di assessment, insieme al cliente e sulla base della sua infrastruttura. Nel tempo possono estendersi ad altri strumenti, grazie a oltre 300 integrazioni già disponibili.
Ogni azione è tracciata in un audit log consultabile, e il cliente riceve aggiornamenti in tempo reale su Microsoft Teams o Slack. Il tempo di risposta si avvicina allo zero, e il cliente resta informato senza dover intervenire.
Vuoi saperne di più su PanOptikon® HyperAutomation e sui servizi di Security Operations di Certego? Contattaci